
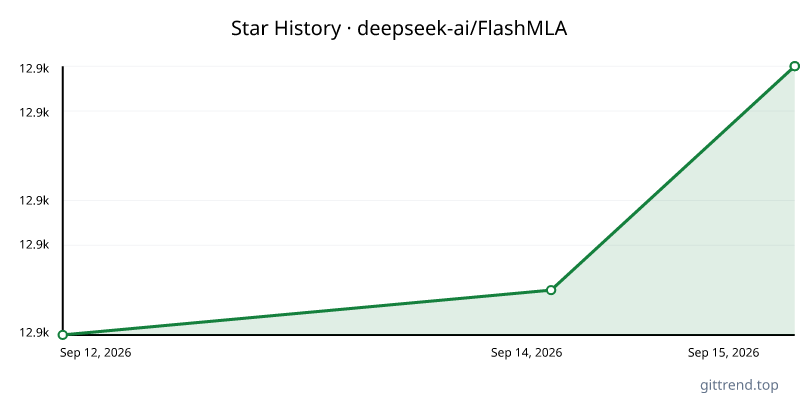
Repository Trajectory
Trended #9 on weekly
January 29, 2026
Trended #9 on daily
January 23, 2026
First tracked on GitTrend
January 23, 2026
Similar Projects
Select up to three alternatives to compare with this repository:
Loading README...
Languages
Cuda
39%
C++
49%
Python
12%
About
FlashMLA: Efficient Multi-head Latent Attention Kernels
Languages
Cuda
39%
C++
49%
Python
12%